En avril dernier, dans mon article « A2Family, MCP, ADK : la guerre des protocoles IA », j’évoquais une évolution qui me semble fondamentale : les agents IA ne vont pas simplement devenir plus intelligents. Ils vont surtout apprendre à interagir entre eux, à accéder à des services et, potentiellement, à réaliser des transactions sans intervention humaine à chaque étape. Rappelons le : la transformation du Web ne concerne pas seulement l’intelligence des modèles, mais l’infrastructure technique et économique qui leur permettra d’agir.
People Inc., Time, Forbes, The Economist et Le Monde commencent à servir leurs contenus à des lecteurs d’un genre nouveau, les agents d’intelligence artificielle. Derrière une décision d’apparence technique, remplacer des pages HTML par du Markdown ou des API, les éditeurs anticipent un Web dont les premiers visiteurs seraient des machines agissant pour le compte d’humains. En première ligne parce que leur modèle économique vacille le plus vite, ils ouvrent une bataille pour la visibilité, la confiance et la valeur des contenus qui concernera bientôt toutes les entreprises.
Pendant trente ans, les sites ont servi deux publics. Les humains réclamaient une interface agréable, des menus, des images, une navigation fluide ; les moteurs de recherche voulaient comprendre la structure des pages pour décider lesquelles méritaient de figurer dans leurs résultats. Le SEO (Search Engine Optimization) est né de cette seconde exigence.
L’IA générative a ensuite imposé le GEO (Generative Engine Optimization), dont l’objectif dépasse le classement dans une liste de liens puisqu’il s’agit d’être identifié, cité ou recommandé dans une réponse produite par ChatGPT, Gemini, Perplexity ou Claude.
Une troisième évolution s’amorce, portée par des agents qui consultent des sources, comparent des produits, naviguent d’un service à l’autre et, parfois, agissent pour leurs utilisateurs. Pour eux, le Web que nous avons bâti est inutilement encombré. Les médias sont les premiers à en tirer les conséquences, car leur valeur tient entièrement dans le contenu que ces agents consomment, et People Inc. pousse la logique plus loin que les autres.
Sommaire
People Inc. : pourquoi faire lire une page web à une machine ?
Petit rappel : People Inc. est le nouveau nom, depuis fin 2025, de Dotdash Meredith, l’éditeur américain de People, Food & Wine ou Travel + Leisure. Selon Digiday, qui publie l’information le 2 novembre 2026 sous la plume de Jessica Davies, le groupe développe des API sur mesure pour que ses partenaires IA accèdent directement à ses articles.
Le raisonnement part d’un constat que tout développeur connaît. Une page d’article contient un menu de navigation, des publicités, des modules de recommandation, des scripts et, quelque part au milieu, le texte. Un navigateur sait assembler tout cela en interface, alors qu’un agent cherche seulement le contenu utile et doit fouiller le reste pour le trouver. Jon Roberts, directeur de l’innovation de People Inc., estime que 90 % d’une page HTML relève du « junk » destiné au navigateur. Le chiffre traduit son appréciation plus qu’une mesure, mais il pointe une réalité économique : chaque élément superflu se paie en tokens, donc en temps de calcul et en coûts.
People Inc. retire donc l’habillage et transmet le texte en Markdown, ce format léger qui balise titres, paragraphes, listes et liens sans la lourdeur du HTML. Les articles arrivent accompagnés de leurs métadonnées : auteur, date de publication, date de mise à jour et autres signaux de confiance. Pour un article fictif sur la cybersécurité, l’agent recevrait directement :
– Titre : Les nouvelles menaces de cybersécurité en 2026
– Auteur : Marie Dupont
– Publication : 28 octobre 2026
– Mise à jour : 2 novembre 2026
– Source : URL de l’article original
– Contenu : texte structuré en Markdown
L’enjeu dépasse l’économie de tokens. En livrant l’auteur et la date avec le texte, l’éditeur rend sa production traçable par des systèmes censés produire des réponses documentées, ce qui ne garantit rien de l’exactitude du contenu mais rend au moins la vérification possible.
Du crawling aux API : l’éditeur reprend la main
La trajectoire de People Inc. raconte un déplacement du pouvoir en trois temps.
Le crawling d’abord.Les partenaires IA explorent le site, récupèrent les pages et en extraient l’information, comme le font les moteurs de recherche depuis toujours. La méthode reste coûteuse et redondante, et l’éditeur la subit plus qu’il ne la pilote.
Les compartiments Amazon S3 ensuite. People Inc. dépose ses contenus dans un espace de stockage ouvert à ses partenaires, ce qui lui permet de pousser des mises à jour et de retirer des articles sans attendre le passage d’un robot.
Les API personnalisées enfin. L’accès passe par une interface conçue pour livrer contenus et métadonnées de façon structurée.
Cette dernière étape change la nature de la relation, car une API organise un échange entre deux systèmes selon des règles fixées par celui qui l’expose. L’éditeur peut y décider quels contenus ouvrir, dans quel format, à quels partenaires et à quelles conditions, puis y adosser authentification, quotas, règles de licence ou mesure des consultations. Rien n’indique que People Inc. exploite déjà toutes ces possibilités. Mais l’infrastructure existe, et elle fait passer l’éditeur d’un modèle où les plateformes viennent se servir à un modèle où il organise lui-même sa distribution auprès des systèmes d’IA. La nuance pèsera lourd au moment de négocier.
Le trafic Web change de nature
Les éditeurs investissent parce que le trafic automatisé, qui touche l’ensemble du Web et pas seulement la presse, grossit vite et, surtout, parce qu’il ne fait plus la même chose. Le 2026 State of AI Traffic & Cyberthreat Benchmark de HUMAN Security] en donne la mesure pour 2025 :
– le trafic automatisé a progressé de 23,51 % sur un an, contre 3,10 % pour le trafic humain ;
– les volumes mensuels de trafic lié à l’IA ont bondi de 187 % entre janvier et décembre ;
– le trafic des agents IA et des navigateurs agentiques a crû de 7 851 % sur un an ;
– les robots d’entraînement pesaient 67,5 % du trafic IA observé, une part en recul de 90 % en janvier à 74 % en décembre.
Le chiffre de 7 851 % impressionne d’autant plus qu’il part d’une base minuscule en 2024, si bien qu’il signale une accélération, pas une domination des agents. HUMAN mesure en outre le trafic qui transite par ses propres outils de protection, ce qui exclut tout recensement exhaustif du Web.
La tendance de fond tient ailleurs, dans la spécialisation des robots. Les training crawlers collectent des données pour entraîner les modèles, les “AI scrapers” récupèrent des informations fraîches pour les moteurs de réponse et la recherche augmentée, et les agents, eux, interagissent avec les sites pour chercher un produit, remplir un formulaire, se connecter ou payer. Selon HUMAN, 77 % de l’activité agentique de 2025 visait des pages produits et de recherche, le reste touchant aux comptes, à l’authentification et aux paiements. Les robots ne se contentent plus de lire le Web, ils commencent à s’en servir pour accomplir des tâches, et les règles du jeu changent avec eux, pour les éditeurs comme pour les entreprises.
Time, Forbes, The Economist, Le Monde : quatre paris sur un Web pour agents
People Inc. n’avance pas seul. Les autres groupes explorent des voies différentes, dont les objectifs se contredisent parfois.
The Economist et le Web à deux voies
En mai 2026, The Economist expliquait à Digiday mener ses « premières expériences » de contenus structurés pour les agents. Le périmètre reste prudent : pages marketing et supports commerciaux B2B, situés hors paywall. Le raisonnement part du constat qu’une part croissante des acheteurs professionnels commence sa recherche dans ChatGPT, Gemini ou Claude, et qu’un agent en quête d’une offre entreprise n’a que faire d’une vitrine soignée. L’éditeur prévoit donc deux versions d’un même argumentaire, une page comparative pour les humains et une version en questions-réponses pour les machines.
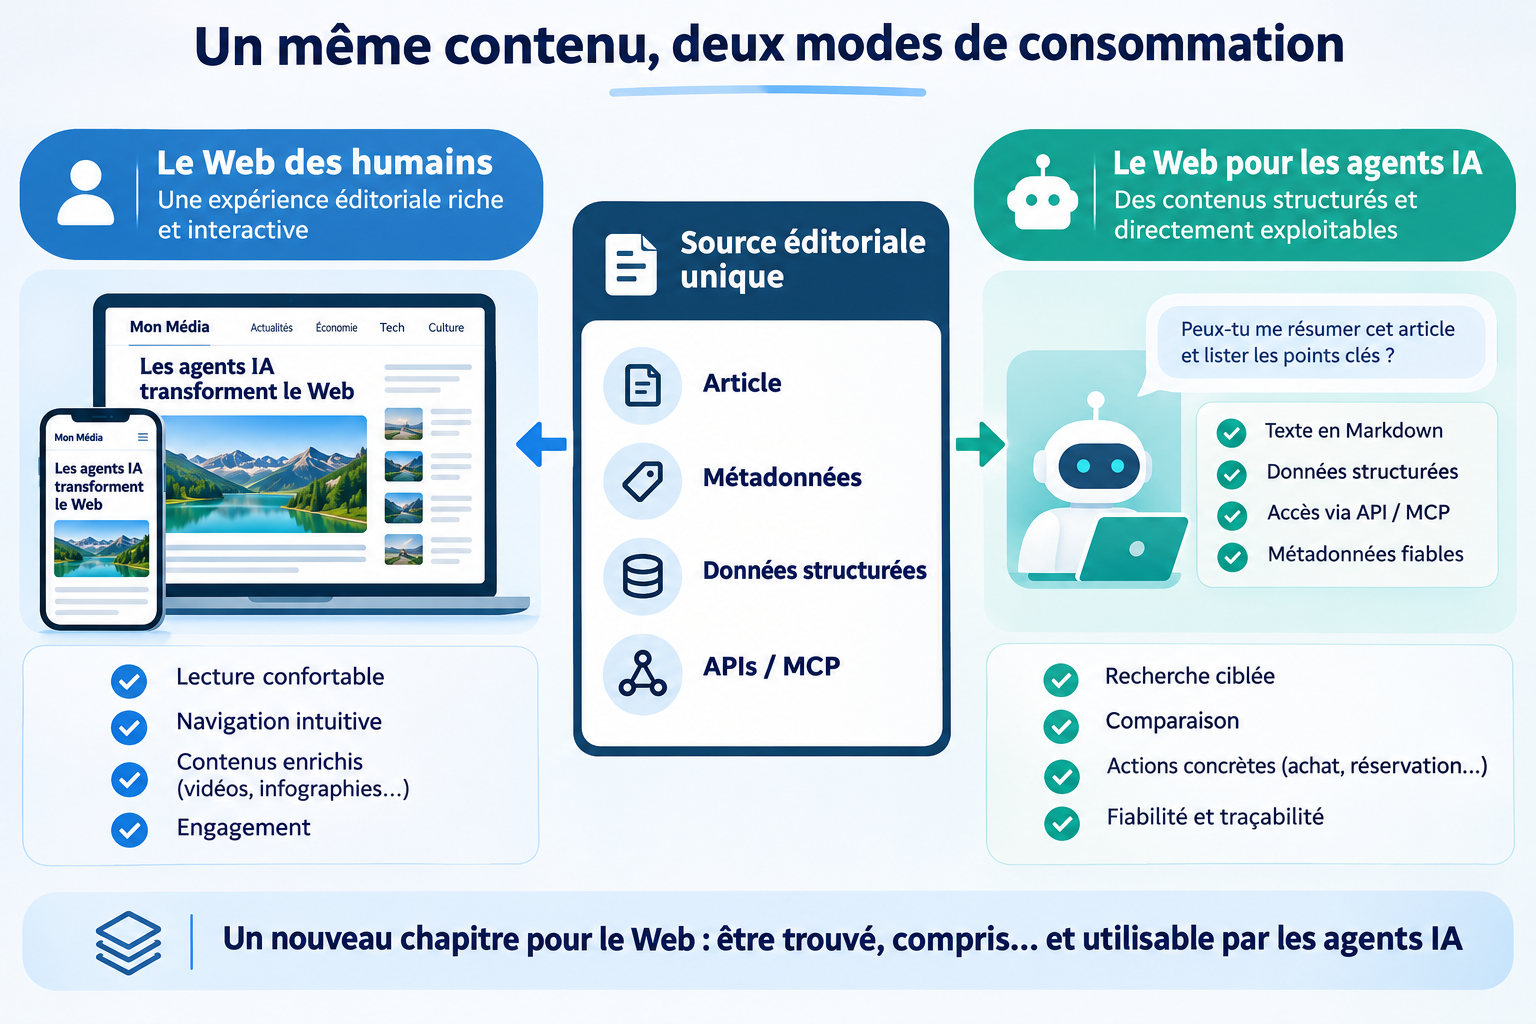
Ce Web à deux voies ne suppose pas deux sites. Un même système éditorial peut produire plusieurs représentations d’un contenu, avec d’un côté l’article enrichi d’images, de graphiques et d’éléments interactifs pour le lecteur, de l’autre le texte, les données structurées, les références et les conditions d’accès pour l’agent. Reste pour un éditeur à abonnement la question qui fâche, celle de la quantité de contenu lisible par les agents qu’il peut ouvrir sans dévaluer l’abonnement.
Time vend de la publicité aux agents
Time a choisi la voie commerciale. Après avoir converti ses pages HTML en Markdown, le magazine a commencé fin juillet 2026 à vendre des publicités destinées aux agents. Avec l’ad tech Mobian, il produit à partir du brief de l’annonceur un contenu en questions-réponses, validé par le client puis inséré dans la version Markdown de la page sous une mention « sponsored content ». Mobian interroge ensuite les moteurs de réponse et suit la manière dont ils reprennent ces informations. Ally Bank et le Project Management Institute figurent parmi les premiers clients.
L’annonceur ne vise plus le regard d’un lecteur mais la mémoire de travail d’un système susceptible, ensuite, de recommander une marque. L’intérêt saute aux yeux, le risque aussi. Que devient le message promotionnel lorsqu’un agent l’intègre à sa réponse comme une information éditoriale indépendante ?
Perplexity a tranché à sa façon. En août 2026, la plateforme a annoncé bloquer l’influence des publicités Markdown de Time sur son index et sur ses agents, en qualifiant la pratique de trompeuse sans définir le terme, et en menaçant les éditeurs récidivistes d’un déclassement de leur score de confiance. La mention « sponsored content » n’y a rien changé. Cet épisode dit l’essentiel du conflit qui s’ouvre : les éditeurs cherchent des revenus, les annonceurs veulent peser sur les recommandations, et les plateformes d’IA s’arrogent le rôle d’arbitre de ce qui mérite d’entrer dans une réponse. Le débat rappelle celui du référencement payant et des contenus sponsorisés, à une différence près, car le lecteur final ne verra peut-être jamais le message promotionnel d’origine.
Forbes mise sur le Markdown et MCP
Forbes avance sur ses recommandations de produits. Pour Vetted, son offre d’évaluations et de sélections, l’éditeur a créé des versions Markdown de certains contenus et une couche MCP. Le Model Context Protocol fournit aux applications d’IA un moyen standardisé de découvrir et d’utiliser les outils et ressources exposés par un serveur, là où une API expose des données selon une interface propre à chaque fournisseur ; les deux approches se complètent plus qu’elles ne s’opposent.
Concrètement, un agent chargé de recommander un ordinateur portable pourrait interroger un service structuré plutôt que de parcourir plusieurs pages, d’en extraire les descriptions et de reconstituer lui-même les critères de comparaison. Rien ne dit que le service Forbes fonctionne déjà ainsi, et Nina Gould, sa directrice de l’innovation, indique qu’un plugin de recommandation pour ChatGPT est prévu mais pas encore en ligne. La direction, elle, ne fait guère de doute : certains éditeurs ne produisent plus seulement des articles à lire, ils les transforment en ressources que des systèmes d’IA peuvent interroger.
Le Monde et l’abonné qui délègue
Le cas français pose un problème d’une autre nature. En juin 2026, Paul Laleu, CTO du Monde, expliquait à Digiday que le quotidien bloque la quasi-totalité du trafic non humain hors accord de licence, selon une règle simple : pas d’accord, pas d’exploration. Mais un abonné qui demande à son assistant de synthétiser plusieurs articles auxquels il a légitimement accès ne peut être traité comme un aspirateur à contenus. Comment distinguer l’agent mandaté du robot pirate ? Le Monde étudie des standards permettant à un assistant de signaler qu’il agit pour un abonné payant, en s’appuyant sur MCP ou sur des extensions de type OAuth. Le chantier qui s’ouvre là, celui de l’identité des agents et des droits qu’ils exercent par délégation, dépasse de loin la presse.
Le GEO ne suffit plus à décrire cette transformation
Le GEO s’est jusqu’ici concentré sur une question : comment augmenter les chances qu’un contenu, une marque ou un expert soit cité par les IA ? Ses recommandations portent sur la structure éditoriale, la clarté des réponses, l’identification des auteurs, les références, les données structurées et la cohérence des informations publiées. Elles gardent leur valeur, mais les expérimentations de People Inc., Forbes ou The Economist ajoutent une dimension qu’elles ignorent, l’accessibilité technique des contenus aux agents.
Trois enjeux se distinguent désormais. Être découvert, d’abord, par les systèmes de recherche classiques ou fondés sur l’IA. Être compris et cité, ensuite, ce qui suppose que la machine identifie le sens d’un document, sa source, sa date, ses références et sa pertinence pour une question donnée. Être exploitable, enfin, c’est-à-dire récupérable dans un format adapté et sous des conditions d’accès lisibles.
Ces dimensions ne se confondent pas. Une API ne garantit pas qu’un système d’IA découvrira la ressource, une page Markdown ne décroche pas mécaniquement davantage de citations, et un serveur MCP, aussi soigné soit-il, n’a rien d’un passe-droit de référencement tant que les agents n’ont aucun moyen de le trouver, d’y accéder et de choisir de l’utiliser. Le GEO traite de visibilité et de représentation dans les réponses ; l’accessibilité agentique pose une question d’infrastructure et d’interopérabilité. Les deux logiques peuvent se renforcer, à condition de les évaluer séparément.
Le véritable enjeu : qui captera la valeur du contenu ?
Le modèle économique du Web éditorial reposait sur une séquence simple. Un moteur référence une page, l’internaute clique, arrive chez l’éditeur, qui monétise la visite par la publicité, l’abonnement ou la vente. Les moteurs de réponse et les agents brisent cette chaîne, puisque l’utilisateur obtient sa réponse sans consulter l’article et délègue à un agent une recherche qui aurait exigé plusieurs visites. Le contenu garde toute son utilité, mais sa consommation ne rapporte plus rien à celui qui l’a produit.
Trois tensions en découlent, à commencer par la rémunération. Quelle contrepartie reçoit l’éditeur dont une plateforme exploite régulièrement les contenus pour servir ses propres utilisateurs ? Le contrôle, ensuite, qui oblige à distinguer une consultation autorisée d’une collecte industrielle, à retirer un contenu, à propager une correction, à faire respecter une licence. L’attribution, enfin, sans laquelle le lien entre une réponse générée et ses sources devient illisible.
Licences d’accès, API réservées aux partenaires, abonnements compatibles avec les agents, services documentaires, publicité d’un genre nouveau : les pistes se multiplient sans qu’aucun modèle s’impose. Le bras de fer entre Time et Perplexity montre au contraire que les règles s’écrivent en ce moment, et que les plateformes entendent bien les écrire elles-mêmes.
Et pour les entreprises, les marques ou les experts indépendants ?
Les médias défrichent, mais ils ne resteront pas seuls sur ce terrain, et les entreprises comme les experts suivront. Prenons un consultant qui dispose de quelques dizaines d’articles de référence, de conférences, de livres blancs et de formations. Aujourd’hui, un internaute le découvre par un moteur de recherche, lit ses publications puis le contacte. Demain, un agent pourra recevoir une consigne du type : « Identifie trois experts français capables d’intervenir sur la gouvernance des agents IA en entreprise, compare leurs travaux et propose-moi une sélection argumentée. » Sa visibilité ne dépendra alors plus seulement du classement d’une page dans Google, mais de la capacité des systèmes à retrouver ses publications, à en saisir le périmètre et la date, à les relier entre elles et à distinguer son expertise de celle des autres. D’où le poids croissant des signaux de provenance, des métadonnées et de la structuration.
Faut-il pour autant que chaque blog professionnel se dote d’une API ou d’un serveur MCP ? Certainement pas en première intention. Pour un site de conseil ou un blog d’expertise, je privilégierais une démarche progressive.
- Première priorité : consolider le socle éditorial.Des auteurs clairement identifiés, des sources citées, des publications datées, des références accessibles, des pages d’expertise cohérentes et des contenus tenus à jour.
- Deuxième priorité : structurer les articles. Des titres explicites, des définitions, des réponses à des questions précises, des méthodologies exposées et une séparation nette entre données, analyses et opinions.
- Troisième priorité : vérifier l’accès réel des systèmes d’IA. Publier une version Markdown ne prouve pas qu’elle sera lue. Il faut étudier quels robots visitent le site, ce qu’ils peuvent atteindre et ce qu’ils récupèrent.
- Quatrième priorité : expérimenter sur un périmètre limité. Une dizaine d’articles de référence, déclinés en versions structurées, sans dégrader l’expérience des lecteurs humains.
- Cinquième priorité : n’envisager une interface dédiée que si un usage la justifie. Une API documentaire a du sens pour une base de connaissances importante, un catalogue professionnel, un service payant ou un assistant spécialisé.
Le critère reste l’utilité démontrée, pas la mode technologique. Il faut aussi cesser de confondre deux objectifs souvent mélangés, rendre les contenus accessibles aux machines et obtenir davantage de citations dans les moteurs de réponse, car le premier se mesure techniquement alors que le second exige des expérimentations dédiées et ne découle pas automatiquement du premier.
Deux Web, une seule source de vérité ?
La perspective la plus féconde reste peut-être celle qu’avance The Economist, un Web à deux faces. D’un côté, celui des humains, avec ses interfaces, son design, ses expériences éditoriales. De l’autre, un Web pour agents, fait de données structurées, d’API, de protocoles et d’informations directement exploitables.
Le HTML ne va pas disparaître pour autant, ni les sites traditionnels. Un agent sait utiliser un navigateur ou lire une page HTML bien construite, et l’interface humaine conserve ce que les machines ne remplacent pas, à savoir le contexte, la confiance, l’expérience, la relation avec une marque ou un média. L’évolution décisive se jouera plutôt dans les coulisses, lorsque les éditeurs organiseront leur production autour d’une source éditoriale unique alimentant une interface pour lire et découvrir, une autre pour rechercher, analyser et agir. Cette architecture soulève à son tour des questions de cohérence entre versions, de propagation des corrections, de gestion des droits et d’identification des agents. Autant de sujets qui relèvent de la gouvernance des contenus au moins autant que du développement informatique.
Les médias en éclaireurs d’une nouvelle bataille de la distribution
Les expérimentations de People Inc., Time, Forbes, The Economist et “Le Monde” ne forment pas encore un modèle industriel, mais elles convergent. Les éditeurs, premiers exposés, traitent désormais les systèmes d’IA comme des intermédiaires à part entière, avec leurs contraintes techniques, leurs usages et leurs modèles économiques potentiels. Pour tout producteur de contenu, la stratégie numérique gagne une dimension : après la qualité, le référencement et la citation, il faut penser les conditions dans lesquelles l’information sera récupérée, comprise, attribuée et utilisée par un agent.
Le passage du SEO au GEO avait placé la visibilité dans les réponses générées au centre du jeu. Le Web agentique déplace la question, de la manière d’être trouvé par l’IA vers celle de devenir une ressource qu’elle peut réellement utiliser. Une partie de la prochaine bataille de la distribution numérique se jouera là, et l’affaire Time-Perplexity en donne déjà le ton. Si les agents deviennent les principaux intermédiaires entre les producteurs de contenus et leurs publics, qui contrôlera l’accès à l’information, et qui en captera la valeur ?

Laisser un commentaire